
 4 weeks ago
17
네이처 리뷰 학술지에 공개한 'CXL 기반 단일 칩형 데이터센터' 구조. 인공지능(AI) 데이터센터 경쟁 축이 '더 빠른 가속기'에서 '가속기를 얼마나 하나의 시스템처럼 묶느냐'로 이동하고 있다. 수백~수천개 가속기가 하나의 AI 모델을 동시에 처리하는 시대가 열리면서 장치 간 통신 지연과 편차가 전체 시스템 성능을 결정하는 새로운 병목으로 떠올랐다. 한 장치가 늦어지면 나머지 장치가 모두 기다려야 하기 때문이다. 국내 팹리스 반도체 기업 파네시아(대표 정명수)와 글로벌 하이퍼스케일러 메타가 이 문제를 정면으로 겨냥했다. 두 회사는 CXL(Compute Express Link)을 기반으로 CPU·가속기·메모리를 하나의 연결 영역으로 묶고, 랙을 넘어 데이터센터 전체가 마치 하나의 거대한 칩처럼 동작하는 차세대 AI 데이터센터 구조를 제시했다. 논문상 구조에서는 CPU 한 개가 직접 관리하는 가속기를 기존 2개에서 16개로 늘리고, 최대 약 960개의 가속기를 하나의 코히런스 도메인으로 묶는다. 관련 연구는 네이처가 발행하는 'Nature Reviews Electrical Engineering(NREE)'에 초청 리뷰 논문으로 게재됐다. 파네시아는 CXL 기반 패브릭을 구현하기 위한 패브릭 컨트롤러와 링크 가속 유닛(LAU)을 실제 실리콘으로 검증했으며 CXL 패브릭 스위치도 칩 제작을 완료했다. CXL 신호를 광통신으로 전달하는 'CXL-over-Optics' 기술의 개념검증(PoC)도 마쳤다고 밝혔다. AI 모델 규모가 커질수록 가속기 숫자도 기하급수적으로 늘고 있다. 문제는 가속기를 많이 연결한다고 성능이 같은 비율로 증가하지 않는다는 데 있다. 대규모 AI 학습에서는 수많은 가속기가 같은 작업을 나눠 처리한다. 각 가속기가 계산한 결과를 서로 주고받으면서 다음 단계로 넘어가기 때문에 모든 장치가 비슷한 시점에 작업을 끝내야 한다. 100개 가속기 가운데 99개가 빠르게 작업을 끝냈더라도 나머지 한 개가 늦으면 전체 시스템이 그만큼 기다려야 한다. 이 때문에 대규모 AI 인프라에서는 평균적인 통신 속도보다 '지연시간 편차'를 줄이는 것이 중요해지고 있다. 가속기 숫자가 많아질수록 가장 느린 장치가 발생할 가능성도 커진다. 현재 AI 데이터센터는 이 문제를 안고 있다. 랙 내부에서는 NVLink와 같은 고속 스케일업 인터커넥트로 가속기를 연결하고, 랙과 랙 사이는 이더넷이나 인피니밴드 같은 스케일아웃 네트워크...
Related
[2026 노벨상] 화학상…제약 설계에 획기적 발견한 이들에게
3 hours ago
3
AMD 리사 수, 삼성서 3시간16분…전영현과 'AI 동맹' 확대 논의[종합]
4 hours ago
4

“게이밍 비전을 공유하는 자리가 아니라 팬미팅 행사였나?” 충격의 AMD 게이머즈 데이
4 hours ago
4
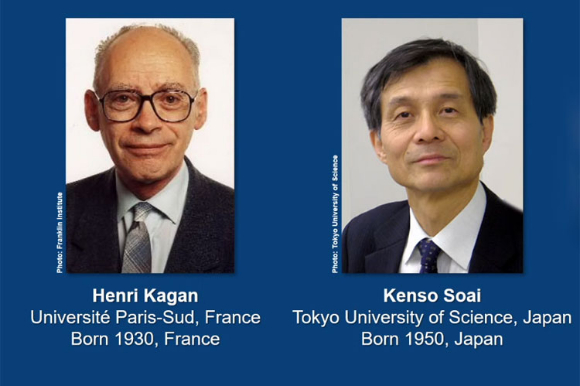
[속보] 노벨화학상에 앙리 카강·소아이 겐소 [2026 노벨상]
7 hours ago
5
과기정통부·KISA, '금융권 해킹 공격자 IP' 민간 5900여곳에 두차례 전파
8 hours ago
5
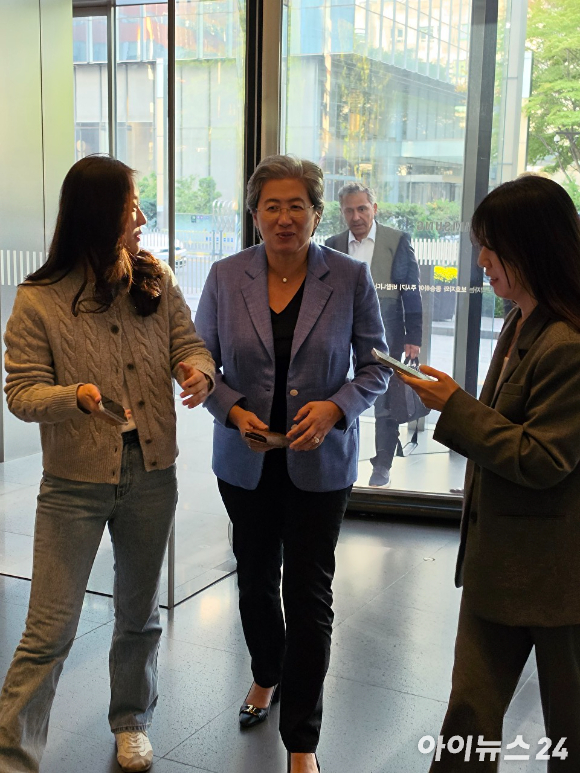
AMD 리사 수, 전영현과 재회…삼성전자와 AI 반도체 협력 논의
8 hours ago
4
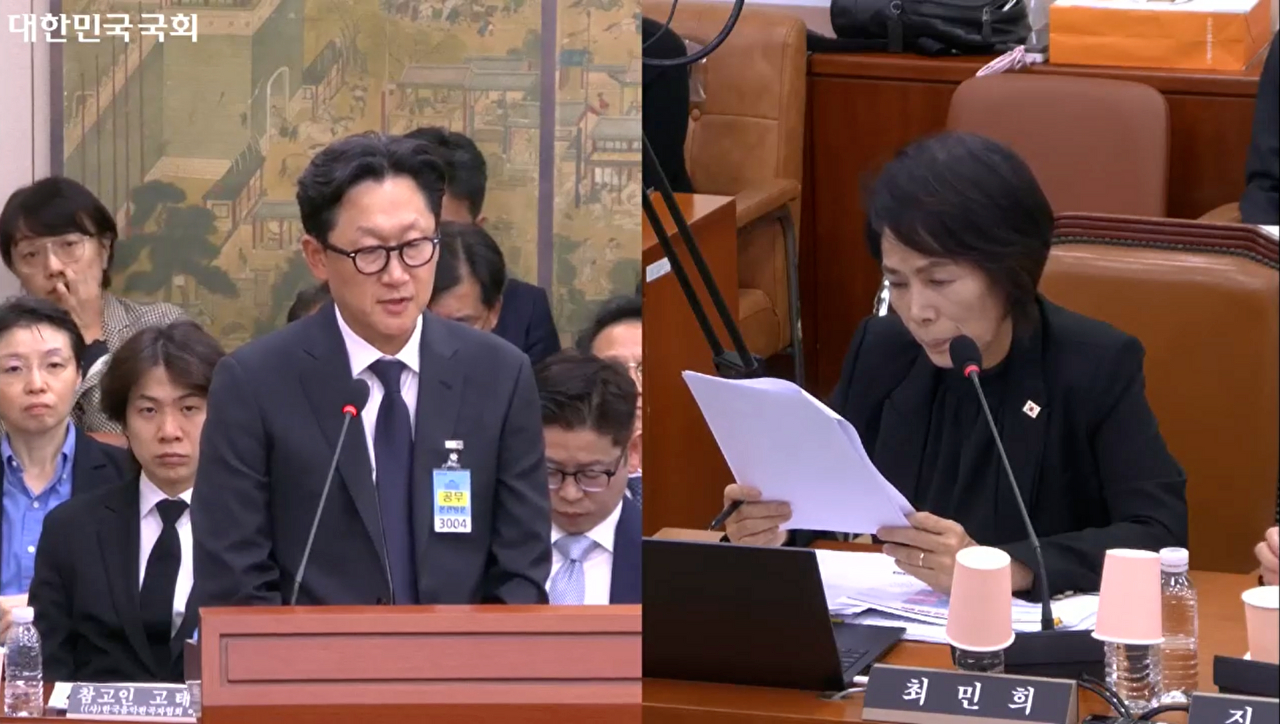
[2026 국감] 최민희 "댓글 없애면 안 되나"⋯네이버 "긍정 기능도, 우려 공...
8 hours ago
4

차는 무거워지는데 안전관리는 '구멍'…기계식 주차장 43.7%가 20년 이상
8 hours ago
5
Popular


프로들도 줄지어 샷 점검… KLPGA 스타 사랑방 된 더헤븐CC 연습장
2 weeks ago
74

iOS 27, iPadOS 27, macOS 27
3 weeks ago
69

손흥민 선제골 발판·골대 불운…LAFC, 7경기 만에 승리
3 weeks ago
65

영림원소프트랩, 나람 통합 ERP 구축…사료 제조·물류·회계 데이터 하나로
2 weeks ago
62

Accelerate your SAP modernization with Kiro
1 week ago
57


'이 악문' 김영범, 자유형 50m '대회 신기록' 금메달
2 weeks ago
56

 English (US) ·
© Clint IT 2026. All rights are reserved
