 8 hours ago
3
9월 한 달을 효율적인 오픈 모델 GLM 5.3 Flash만으로 개발하려 했지만, 전체 20억 토큰 중 해당 모델 사용량은 10억 토큰에 그침 첫 보름은 단일 모델 사용에 성공했고, GLM 5.3 Flash 사용 비용은 68달러, 에너지 사용량은 약 4kWh로 예산 안에 머묾 프로토타입의 모델 선택과 에이전트 활용 방식, 추론 인프라 가용성 문제, 연구개발을 위한 다양한 모델 실험 때문에 다른 모델 사용이 늘어남 100만 토큰 컨텍스트와 이미지 처리 지원, 다양한 공급자 선택지를 갖춘 GLM 5.3 Flash는 Wagtail 개발, UI 작업, 문서 작성, 평가 등에서 폭넓게 활용 가능했음 일상적인 개발은 저렴한 Flash급 모델 한두 개에 집중해도 충분히 가능하며, 다음 목표는 비용이나 에너지 사용량 기준으로 효율적인 모델이 추론 작업의 대부분을 담당하도록 하는 것임 단일 오픈 모델 도전과 실제 사용량 9월 한 달 동안 효율적인 오픈 모델 하나만 사용하기에 도전했으며, 목표 모델은 GLM 5.3 Flash였음 사용량은 에이전트 엔지니어링 권장 사항에 포함된 AgentsView로 추적함 첫 보름은 목표 모델만 사용하는 데 성공함 해당 모델 사용량은 비용 68달러, 에너지 약 4kWh, 탄소 배출량 365g으로 예산 범위 안이었음 후반부에는 다른 모델에 10억 토큰을 사용함 최종적으로 목표 모델의 비중은 전체 20억 토큰 중 10억 토큰, 50% 에 그쳐 단일 모델 도전은 실패함 전체 에너지 사용량도 목표였던 10kWh 대신 약 35kWh에 달함 바이브 코딩 프로토타입의 비용 실험적인 Wagtail MCP 서버는 바이브 코딩으로 만든 프로토타입임 바이브 코딩은 평소 지향하는 개발 방식은 아니지만, 프로토타입에는 적합했음 다만 부적절한 모델 선택으로 거의 하룻밤 사이에 4억 5,000만 토큰, 150달러, 5kWh를 사용함 MCP 서버 자체는 잘 작동하고 기능을 보여주는 좋은 데모도 확보했지만, 큰 노력을 더하지 않고도 비슷한 결과를 비용 약 5분의 1로 얻을 수 있었을 가능성이 높음 프로토타입에도 별도 예산을 잡고, 모델 선택과 에이전트 활용 패턴을 더 신중하게 결정할 필요가 있음 추론 인프라 가용성과 모델 전환 오픈 웨이트 모델과 추론 공급자 비교를 거쳐 선택한 공급자들은 대부분 잘 작동했지만, 인기가 높고 GPU를 대량 확보한 대형 AI 연구소만큼의 처리 용량은 갖추지 못함 특히 GLM 5.3 Flash의 성...
Related

Claude와 Claude Code에서 Opus 5.5를 최대한 활용하는 방법
26 minutes ago
0
Woking 전력 제어실 (2016)
29 minutes ago
0
도시 건설 게임에는 영혼이 부족하다, 2부
1 hour ago
0
모두가 짐을 싸고 있다
1 hour ago
0
Hole Punch - 중력장을 이용해 우주선을 날리는 게임
1 hour ago
0
FTL, 클라우드를 위한 새로운 운영체제
1 hour ago
0
우라늄 큐브가 드러낸 사실, 나치 독일에는 원자폭탄을 만들 가망이 없었다
2 hours ago
0
ADHD, 자폐증, 아니면 복합 트라우마인가? [PDF]
2 hours ago
0
Popular

손흥민 선제골 발판·골대 불운…LAFC, 7경기 만에 승리
3 weeks ago
64

iOS 27, iPadOS 27, macOS 27
2 weeks ago
58
프로들도 줄지어 샷 점검… KLPGA 스타 사랑방 된 더헤븐CC 연습장
2 weeks ago
58
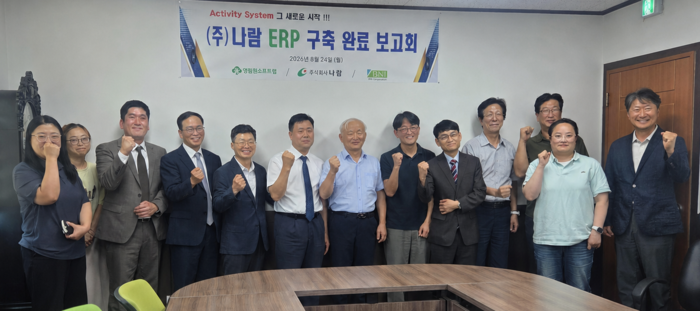
영림원소프트랩, 나람 통합 ERP 구축…사료 제조·물류·회계 데이터 하나로
2 weeks ago
57

OpenAI 에이전트들이 RubyGems에 공개되지 않은 공격을 수행함
3 weeks ago
52
 English (US) ·
© Clint IT 2026. All rights are reserved
