서효빈 기자 입력 2026.10.20 17:27 클로드 4개·GPT 2개 영역 1위…젬마는 지시 수행 최고점 국내 카카오·LG·KT·SKT 영역별 강점…수학은 채점 기준 따라 1위 달라져 [아이뉴스24 서효빈 기자] 서울대학교 연구진이 국내외 인공지능(AI) 모델의 한국어 능력을 평가한 결과 해외 AI가 모든 평가 영역에서 높은 성적을 기록했다. 국내 AI는 평가 영역에 따라 서로 다른 강점을 보였다.ChatGPT 생성이미지 [사진=ChatGPT]20일 논문 사전공개 사이트 '아카이브(arXiv)'에 따르면 서울대 데이터사이언스대학원과 컴퓨터공학부 연구진은 '한국어 파운데이션 모델 평가를 위한 벤치마크 모음(KBS)' 논문에서 국내외 AI 모델을 대상으로 총 9396개 문항을 활용해 한국어 성능을 평가했다.평가 영역은 과학 문제 해결, 수학 추론, 감정 이해, 상식·문맥 추론, 문학 문맥 이해, 지시 수행 등 6개다. 과학 문제는 기초와 고난도로 나눠 총 7개 세부 영역에서 성능을 비교했다.국내에서는 SK텔레콤 'A.X 4.0', KT '믿:음 2.0', LG AI연구원 '엑사원 4.0', 네이버 '하이퍼클로바X', 카카오 '카나나2' 등 5개 모델 계열이 평가 대상에 포함됐다. 해외에서는 오픈AI 'GPT-5.5', 앤트로픽 '클로드 오푸스 4.7', 구글 '젬마4', 알리바바 '큐웬3.5' 등을 평가했다.◇해외 AI, 7개 영역 석권…클로드 4개·GPT 2개 1위평가 결과 해외 AI 모델이 7개 세부 영역 모두에서 국내 AI보다 높은 최고 점수를 기록했다.앤트로픽 '클로드 오푸스 4.7'은 과학 기초 문제에서 99.12%의 정답률을 기록했다. 상식·문맥 추론에서는 93.37%, 문학 문맥 이해에서는 98.76%로 가장 높은 성적을 거뒀다. 감정 이해에서도 79.23점으로 전체 평가 모델 가운데 1위를 차지했다.오픈AI 'GPT-5.5'는 과학 고난도 문제에서 97.77%, 수학 추론에서 96.29%의 정답률을 기록해 각각 최고 성적을 거뒀다.지시 수행 영역에서는 구글 '젬마4 31B-it'가 85.02%로 가장 높은 점수를 기록했다. GPT-5.5는 81.09%, 클로드 오푸스 4.7은 79.55%였다.국내 AI와 해외 AI 간 격차는 평가 영역에 따라 달랐다. 과학 기초 문제에서 해외 최고 모델과 국내 최고 모델의 정답률 차이는 3.71%포인트였지만 상식·문맥 추론에서는 23.60%포인트까지 벌어졌다.◇국...
Related

‘AGF’에 모이는 국내 주요 게임사들…서브컬처 팬 공략
31 minutes ago
0

[스타트업-ing] 차량마다 구축하던 eCall, 이제 SaaS 플랫폼으로 구독한다
33 minutes ago
0
[일문일답] 인적분할 주총 2개월 앞으로⋯소액주주 설득 나선 카카오 "자회사 매각 無"
37 minutes ago
0
정보보호 공시 의무 확대…내년부터 모든 상장사 적용
39 minutes ago
0

[콘텐츠 핫&뉴] ‘창세기전 모바일’, 신규 캐릭터 ‘베타’ 무료 제공
56 minutes ago
0
구름 가려도 사진 선명하게, 위성영상 AI 外 [과학게시판]
59 minutes ago
0
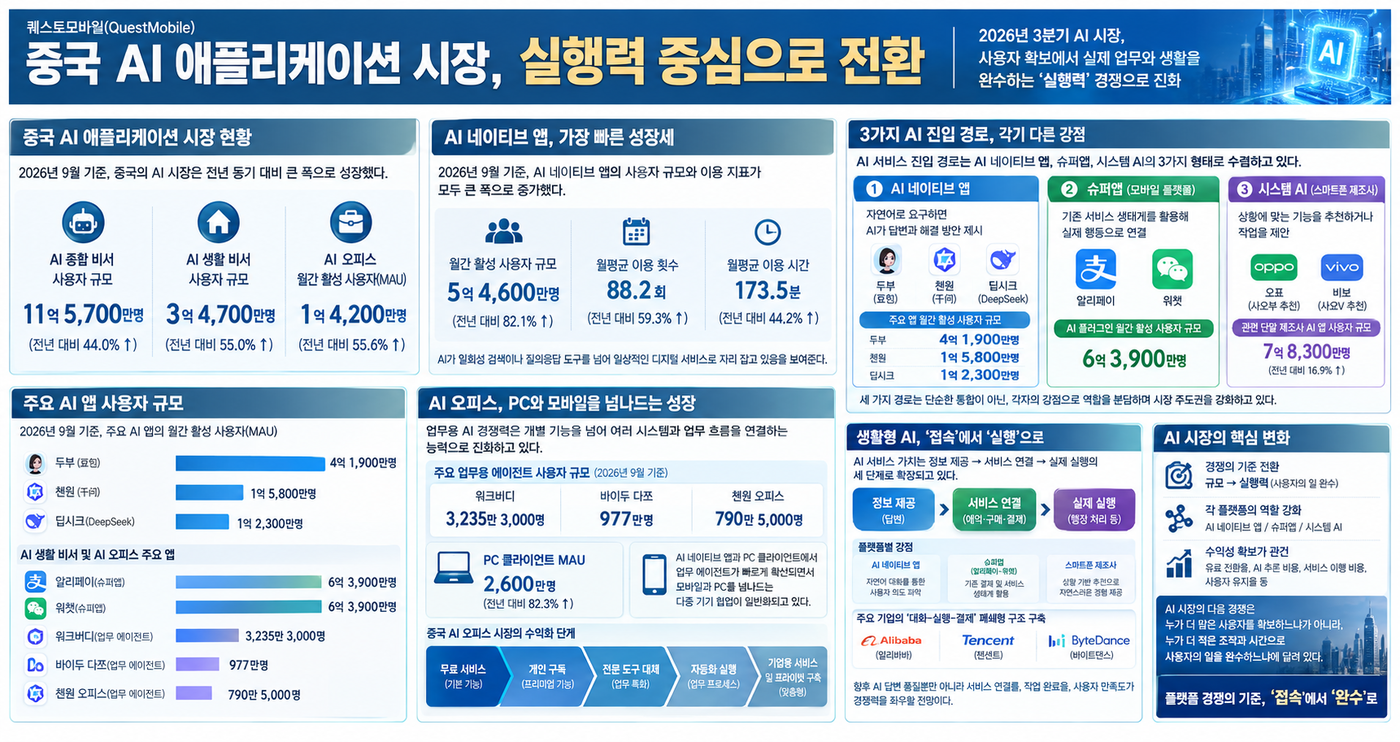
[테크 차이나] 中 AI 시장, 실행력 중심으로 전환…AI 네이티브 앱 이용자 5억4600만명
1 hour ago
0
[르포] “AI가 알아서 빨래 정리”…제논 '피지컬 AI 두뇌' 개발 현장
1 hour ago
0
Popular

[아시안게임] 유도 김민종, 남자 100㎏이상급 동메달…2회 연속 메달
2 weeks ago
230

How DataXStream Accelerates Sales and Customer Engagement wi...
2 weeks ago
220
마이크론이 먼저 확인한 메모리 호황…삼성·SK하이닉스는 '비용 변수'
2 weeks ago
220
[2026 노벨상] 생리의학상…뇌에 대한 이해 바꿔놓은 이들에게
2 weeks ago
218

직장인으로서 부를 쌓는 방법
1 week ago
217
Show GN: 5달러 시계에 Claude·Codex 사용량을 띄워봤습니다
2 weeks ago
215

박진영, 12월 서울서 사흘간 연말 콘서트 '웨트'
2 weeks ago
215

Accelerate your SAP modernization with Kiro
2 weeks ago
211
방탄소년단, 자체예능 '달려라 방탄 2.0'으로 돌아온다
2 weeks ago
210
로민 '다큐먼트 AI 플랫폼', KISA 클라우드 보안인증 획득
2 weeks ago
205
 English (US) ·
© Clint IT 2026. All rights are reserved
