 56 minutes ago
1
어텐션만 사용하는 0~2층 Transformer를 토큰에서 출력 로짓까지 이어지는 계산 경로로 분해해, 가중치에서 모델의 동작을 읽어내는 기계적 해석 가능성 프레임워크를 구축함 어텐션 헤드를 어디서 정보를 가져올지 결정하는 QK 회로와 가져온 정보가 출력에 미치는 영향을 결정하는 OV 회로로 나누며, 어텐션 패턴을 고정하면 나머지 계산은 선형이 됨 0층 모델은 바이그램 통계를, 1층 모델은 바이그램과 스킵 트라이그램의 앙상블을 구현함. 1층에서도 문맥 속 토큰을 복사하는 기초적인 문맥 내 학습이 가능하지만, 인수분해된 표현 때문에 잘못된 조합도 생성됨 2층 모델의 귀납 헤드(induction head) 는 이전 토큰 헤드와의 합성으로 앞서 나온 [a][b]를 찾아 현재 [a] 다음에 [b]를 예측하며, 무작위 토큰열의 반복에서도 이 동작을 확인함 분석은 작은 실험용 모델에 한정되며, 일반 Transformer 매개변수의 약 3분의 2를 차지하는 MLP는 여전히 큰 미해결 영역임. 후속 정정에서는 분석한 2층 모델에 최초 도표보다 더 많은 헤드 합성이 있음을 확인함 연구 목적과 실험 범위 기계적 해석 가능성(mechanistic interpretability) 은 복잡한 바이너리를 소스 코드로 역공학하듯, 신경망이 수행하는 세부 계산을 복원하려는 접근임 대규모 언어 모델에서는 학습이 끝난 뒤에도 예상하지 못한 능력과 유해한 행동이 발견됨 계산을 복원할 수 있다면 현재의 안전 문제를 설명하고 새로운 문제를 찾으며, 아직 개발되지 않은 모델의 문제를 예상하는 데도 도움이 될 가능성이 있음 연구는 Distill Circuits의 비전 모델 역공학을 Transformer로 확장하기 위한 초기 단계이며, MLP가 없는 0~2층 자기회귀 디코더 모델을 대상으로 함 96층에서 어텐션과 MLP를 번갈아 사용하는 GPT-3 같은 모델과 비교하면 크게 단순화된 구조임 작은 모델에서 발견한 알고리듬과 회로 패턴을 더 복잡한 모델에 적용할 발판을 만드는 것이 목표임 실험 모델은 보통 12개 헤드와 헤드당 64차원을 사용하며, 별도로 32개 헤드와 헤드당 128차원 모델도 분석함 모델 차원은 헤드 수와 헤드 차원의 곱이며, 문맥 길이는 2,048토큰이고 밀집 어텐션을 사용함 위치 정보는 잔차 스트림에 넣지 않고 쿼리와 키를 계산하기 직전에 사인파 임베딩으로 더함 학습 데이터셋은 Kaplan 등의 연구에서 기술한 구성을 따름 수학적 전개...
Related

GNU Guix로 전환하기: 초보자의 시각
32 minutes ago
0
LG, TV 감시 의혹에 반박
53 minutes ago
0
Show GN: 네오프레스 - Next.js 기반 AI 웹사이트 빌더에 CMS·SEO·전환 분석을 묶었습니다...
53 minutes ago
0
10억 명 이상의 ChatGPT 사용자를 지원하기 위한 온라인 스토리지의 빠른 확장
1 hour ago
0
루마니아 축구, 학부모의 폭언과 폭력에 대응하는 블랙카드 도입
1 hour ago
0
Ask HN: 어떤 작업을 하고 계신가요? (2026년 9월)
1 hour ago
0
Signal의 전화번호 없는 가입에 영지식 증명 사용 예정
3 hours ago
0
Popular
[팟캐스트] OAuth, 제대로 이해하고 쓰고 있나요?
3 weeks ago
89
고철
3 weeks ago
87

연상호, 토론토영화제서 고레에다 감독과 대담
3 weeks ago
77

‘붉은사막’, 게임스컴 어워드 에픽·최고의 PC 게임 후보작 올라
2 weeks ago
73
취준생 목소리에 귀기울인 '라이너 라이트'..."자소서 기능 이용자 수 13배 늘...
2 weeks ago
71
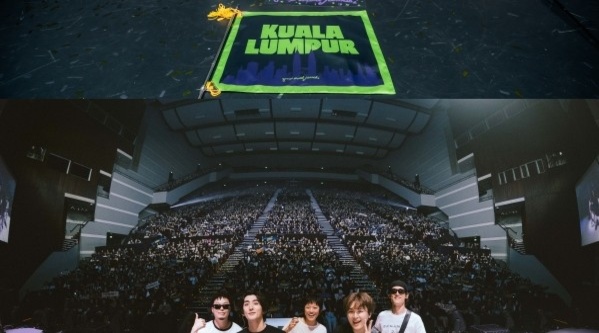
잔나비, 첫 아시아 투어 곳곳서 떼창 물결…"기적같은 일"
3 weeks ago
69
김재윤 통산 220세이브…삼성, 2연패 탈출
3 weeks ago
68
컴투스, 신작 '제우스: 오만의 신' 사전 다운로드 당일 애플 앱스토어 인기 1위
2 weeks ago
56

남궁훈 아이즈 대표, 카카오게임즈 지분 1% 매입…"게임산업 다시 성장할 것"
3 weeks ago
55

 English (US) ·
© Clint IT 2026. All rights are reserved
