 1 hour ago
3
도구 호출이 스키마를 어기면 오류 메시지와 재시도가 쌓여 에이전트의 품질과 비용에 영향을 줌. Ubicloud의 Kimi K2.6 테스트에서는 vLLM 0.28의 스키마 정확도가 92% 에 그쳤음 제약 디코딩(constrained decoding) 은 생성 단계마다 스키마에 맞지 않는 토큰을 차단해, 생성 후 검증에 의존하지 않고 도구 호출의 구조적 유효성을 강제함 vLLM은 XGrammar의 구조 태그로 도구 호출 형식과 JSON 스키마를 정의하며, 미리 계산한 토큰 마스크를 GPU에 적용해 성능 부담을 거의 늘리지 않고 제약을 적용함 제약 디코딩은 모든 모델에서 안전한 기본값은 아님. 모델별 출력 특성과 구현 버그 때문에 vLLM은 기본 비활성화를 선택했고, 0.31에서 서버 측 설정 플래그를 제공함 관측되는 모델 품질은 모델 자체뿐 아니라 추론 엔진과 설정에도 좌우됨. 스키마 준수를 강제할 수 있어도 모델별 동작과 다른 추론 기능과의 상호작용을 고려해야 함 도구 스키마와 호출 처리 과정 LLM이 외부 도구를 호출하려면 사용 가능한 도구 목록과 구조화된 호출 출력 방법을 전달해야 함 OpenCode가 Kimi에 연결될 때는 도구를 설명하는 JSON 배열을 전송함 예시 도구인 webfetch는 웹페이지를 가져오며, 필수 문자열 url, 선택적 format, 초 단위 timeout을 받음 format은 text, markdown, html 중 하나이며 기본값은 markdown, timeout의 최댓값은 120초임 도구 스키마는 매개변수 이름, 자료형, 필수 여부 등을 정의하며, 에이전트 하네스가 호출을 실행하려면 모델 출력이 이 규칙을 따라야 함 추론 엔진은 도구 설명 JSON을 모델별 특수 토큰으로 감싸 학습 당시의 도구 선언 형식에 맞춰 전달함 Kimi에서는 <|im_system|>tool_declare<|im_middle|>...<|im_end|> 형태를 사용함 모델이 도구 이름과 인수를 특수 토큰 사이에 출력하면 추론 서버의 파서가 이를 일반 응답과 tool_calls가 포함된 JSON으로 변환함 OpenCode 같은 하네스는 이 응답을 받아 webfetch를 실행하고 결과를 모델에 다시 전달함 스키마 정확도가 에이전트 품질에 미치는 영향 모델이 자유롭게 도구 호출을 생성하도록 두는 방식은 학습만으로 올바른 구조를 출력할 것이라고 신뢰함 최신 모델은 구조적 패턴을 대체로 ...
Related

Stalwart v1.0: 지구상에서 가장 빠른 메일 서버
17 minutes ago
0
AI 시대의 맨먼스 미신
49 minutes ago
0
Show GN: HypeSeoul – AI가 그린 서울 전체, 서울 시간대로 움직이는 지도
1 hour ago
3
Show GN: 봉오리 - 질문에 답하다 보면 하루가 정리되는 AI 일기
2 hours ago
3
Show GN: 카드 배틀 - Decision Model을 이용한..
2 hours ago
3
미래에서 온 남자: Johnny는 왜 추상화를 멈추지 못했나
3 hours ago
3
Nietzschian Debugger - 답 대신 질문으로 스스로 버그 원인을 찾게 하는 디버거
4 hours ago
4

손가락을 튕기기로 LLM 비용 줄이기
5 hours ago
4
Popular
직장인으로서 부를 쌓는 방법
2 weeks ago
409

[아시안게임] 유도 김민종, 남자 100㎏이상급 동메달…2회 연속 메달
3 weeks ago
336
[2026 노벨상] 생리의학상…뇌에 대한 이해 바꿔놓은 이들에게
3 weeks ago
329
Show GN: 5달러 시계에 Claude·Codex 사용량을 띄워봤습니다
3 weeks ago
328
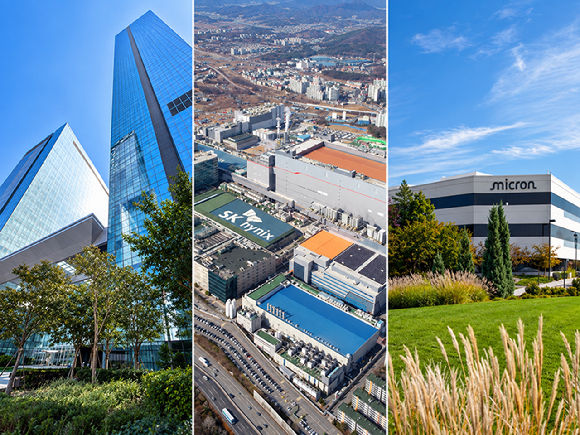
마이크론이 먼저 확인한 메모리 호황…삼성·SK하이닉스는 '비용 변수'
3 weeks ago
324
Show GN: suta — AI가 생성한 UI문제를 줄이는 스킬
2 weeks ago
322

How DataXStream Accelerates Sales and Customer Engagement wi...
3 weeks ago
322
방탄소년단, 자체예능 '달려라 방탄 2.0'으로 돌아온다
3 weeks ago
320

박진영, 12월 서울서 사흘간 연말 콘서트 '웨트'
3 weeks ago
320
로민 '다큐먼트 AI 플랫폼', KISA 클라우드 보안인증 획득
3 weeks ago
316
 English (US) ·
© Clint IT 2026. All rights are reserved
