 7 hours ago
3
Strata는 1,250억 매개변수 모델 Qwen3.8-Flash-Next를 일반 PC에서 실행하는 무료 오픈소스 도구로, 대화, 코드 작성, 이미지 읽기와 코딩 에이전트 연동을 지원하며 데이터는 PC 밖으로 나가지 않음 GPU, RAM, CPU, SSD에 작업을 분산해 모델을 구동함. 자주 쓰는 전문가를 GPU에 두고 나머지는 CPU가 병렬 처리하며, 작은 보조 모델의 예측을 큰 모델이 검증해 같은 답을 1.6~1.8배 빠르게 생성함 README 실측에서 RTX 5070 12GB는 Q2_0 기준 답변 생성 94토큰/초, 32K 프롬프트 처리 2,650토큰/초를 기록했고, RX 9070 XT 16GB는 각각 60토큰/초와 1,160토큰/초를 기록함 기본 요구 사양은 VRAM 12GB 이상, RAM 32GB 이상이며, RAM 용량에 따라 모델 선택이 달라짐. 작은 양자화 모델은 더 빠르고, 큰 모델은 조금 더 높은 성능을 내지만 메모리 부족 시 SSD를 읽느라 느려짐 OpenAI 호환 API, Anthropic API, OpenAI Responses API로 앱과 코딩 도구에 연결할 수 있음. 기본값은 한 번에 요청 하나를 처리하며, 12GB GPU에서 동시 처리를 켜면 개별 답변 속도가 떨어짐 PC 전체에 분산하는 모델 실행 구조 Strata는 일반 PC에서 Qwen3.8-Flash-Next를 실행하며, 대화, 코드 작성, 이미지 읽기와 앱/코딩 에이전트 연동을 지원함 모델의 24,576개 전문가(expert) 중 단어 하나를 처리하는 데 필요한 전문가는 10개뿐임 GPU에는 가장 자주 사용하는 수천 개 전문가를 유지함 RAM에는 모든 전문가를 보관하고, CPU가 GPU에 없는 전문가의 작업을 동시에 처리함 SSD에는 대형 조회 테이블을 저장함 보조 모델의 예측과 큰 모델의 검증을 결합함 작은 모델이 다음 몇 단어를 예측하면 큰 모델이 한 번에 확인하고 올바른 예측을 채택함 같은 답을 1.6~1.8배 빠르게 얻을 수 있음 긴 텍스트는 한 번에 최대 8,192토큰씩 처리하며, 처리 속도는 초당 1,000토큰 이상임 구조와 수치는 작동 원리, 기술 상세, 논문에서 확인할 수 있음 실측 성능과 측정 범위 답변 생성 속도는 짧은 대화에서 답이 출력되는 속도이며, 프롬프트 처리 속도는 32K토큰 문서, 코드 또는 대화 기록을 읽는 속도임 RTX 5070 12GB, Ryzen 5 7600, RAM 64GB 구성의 실측 결...
Related

소화기까지 숨기는 Apple의 ‘깔끔한 디자인’은 어리석은 짓이다
21 minutes ago
0
뉴욕시는 새로운 나무를 정밀 측정해야 한다
24 minutes ago
0
부실한 가림 처리로 Google 데이터센터의 물과 전력 사용량 드러나
27 minutes ago
0
macOS 27에서 Apple Intelligence를 끄고 디스크 공간 되찾기
30 minutes ago
0
Thoreau BASIC - BASIC이 유행에서 밀려나지 않았다면?
1 hour ago
1
Big Balls, 이제 최소 6개 주에서 중대한 형사 기소 가능성에 직면
1 hour ago
1
전직 SR-71 엔지니어가 말하는 NASA의 Blackbird 부활 프로그램
1 hour ago
1
VGHF 디지털 아카이브, 잡지 5,000권 돌파와 향후 계획
1 hour ago
0
Popular

손흥민 선제골 발판·골대 불운…LAFC, 7경기 만에 승리
3 weeks ago
64
프로들도 줄지어 샷 점검… KLPGA 스타 사랑방 된 더헤븐CC 연습장
2 weeks ago
64
iOS 27, iPadOS 27, macOS 27
2 weeks ago
62
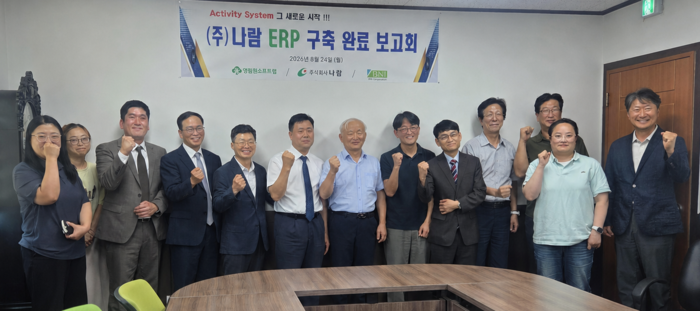
영림원소프트랩, 나람 통합 ERP 구축…사료 제조·물류·회계 데이터 하나로
2 weeks ago
60

OpenAI 에이전트들이 RubyGems에 공개되지 않은 공격을 수행함
3 weeks ago
52

유키 9단, 4연승 질주…일본, 농심백산수배 깜짝 선두
2 weeks ago
50
 English (US) ·
© Clint IT 2026. All rights are reserved
