 1 hour ago
1
Jeff는 상황과 선택지를 자연어로 입력하면 단 한 번의 순전파로 선택지별 보정된 확률을 반환하는 소형 분류 모델임. 텍스트 생성이나 응답 파싱 없이 로컬 코드에 넣어 사용할 수 있음 Qwen3.5와 Gemma 4를 미세조정했으며, 0.8B 모델의 결정 시간은 RTX PRO 6000에서 22ms, Apple M4 Max의 MLX에서 28ms임 5개 공개 벤치마크에서 Jeff-2B는 종합 83.1%, Jev의 공개 수치는 83.0%였음. 다만 평가 표본이 서로 다르며, Jeff는 분류와 근거 확인에 강하지만 추론 중심 과제에서는 크게 뒤처짐 학습과 합성 데이터 생성, 테스트를 모두 로컬 하드웨어에서 수행함. 학습 데이터에 폐쇄형 모델의 출력을 사용하지 않았으며, 0.8B 모델 학습에는 워크스테이션 GPU 한 장으로 약 2시간이 걸림 분류기이지 계획기는 아니므로 코드에서 선택지의 결과를 계산하고 Jeff가 고르게 하는 방식에 적합함. 제로샷 성능이 부족했던 음성 내비게이션에서는 약 30분의 추가 미세조정으로 홀드아웃 정확도가 31.7%에서 95.8%로 높아짐 자연어 선택지를 확률로 바꾸는 모델 제로샷 분류를 위해 Qwen3.5와 Gemma 4를 미세조정한 모델로, 상황과 선택지를 설명하면 각 선택지의 확률, 선택한 항목, 신뢰도를 반환함 지원 요청 분류, 사용자 의도, 콘텐츠 검토 레이블, 음성 명령, 게임 행동 등에 사용할 수 있음 범주가 학습 데이터에 등장하지 않았더라도 자연어로 설명해 선택하게 할 수 있음 Jev와 같은 요청 형식을 사용하며, /v1/systemone에서 세 가지 질문 유형을 지원함 choice: 최대 255개 선택지 중 하나를 고름 noul: 예/아니요 질문에 확률로 응답함 score: 사용자가 설명한 척도 위의 값을 반환함 독립적인 질문 여러 개를 한 요청에 넣어 함께 처리할 수 있음 공개 모델은 Jeff-Qwen3.5-0.8B, Jeff-Qwen3.5-2B, Jeff-Gemma4-E2B임 영어와 텍스트만 지원함. NVIDIA GPU와 CPU에서는 PyTorch로, Apple silicon에서는 MLX로 실행할 수 있으나 MLX 백엔드는 Qwen 모델만 지원함 Jev 제작사 TypeSafe와 무관한 독립 프로젝트이며, 제휴나 공식 승인을 받지 않음 벤치마크 성능과 비교의 한계 5개 공개 벤치마크의 4,599개 질문을 평가하고, JevBench의 공개 hard 등급 105개 항목은 별도로 채...
Related

World Labs, AMD에 합류
1 hour ago
1
AI 연구소를 조사할 때다
1 hour ago
1
DuckDB 2.0이 더 빠른 이유
1 hour ago
1
인덱스 하나 더의 참을 수 없는 가벼움
1 hour ago
1
Diskless Kafka: 브로커가 데이터를 소유하지 않으면 무엇이 달라질까?
1 hour ago
1
대부분의 기술 혁명은 직원들의 일을 더 힘들게 만들었다
1 hour ago
1
진지한 AI 제품은 어떤 모습이어야 할까?
2 hours ago
1
Show HN: HN.watch - 모든 Hacker News 게시물을 영상으로
3 hours ago
1
Popular


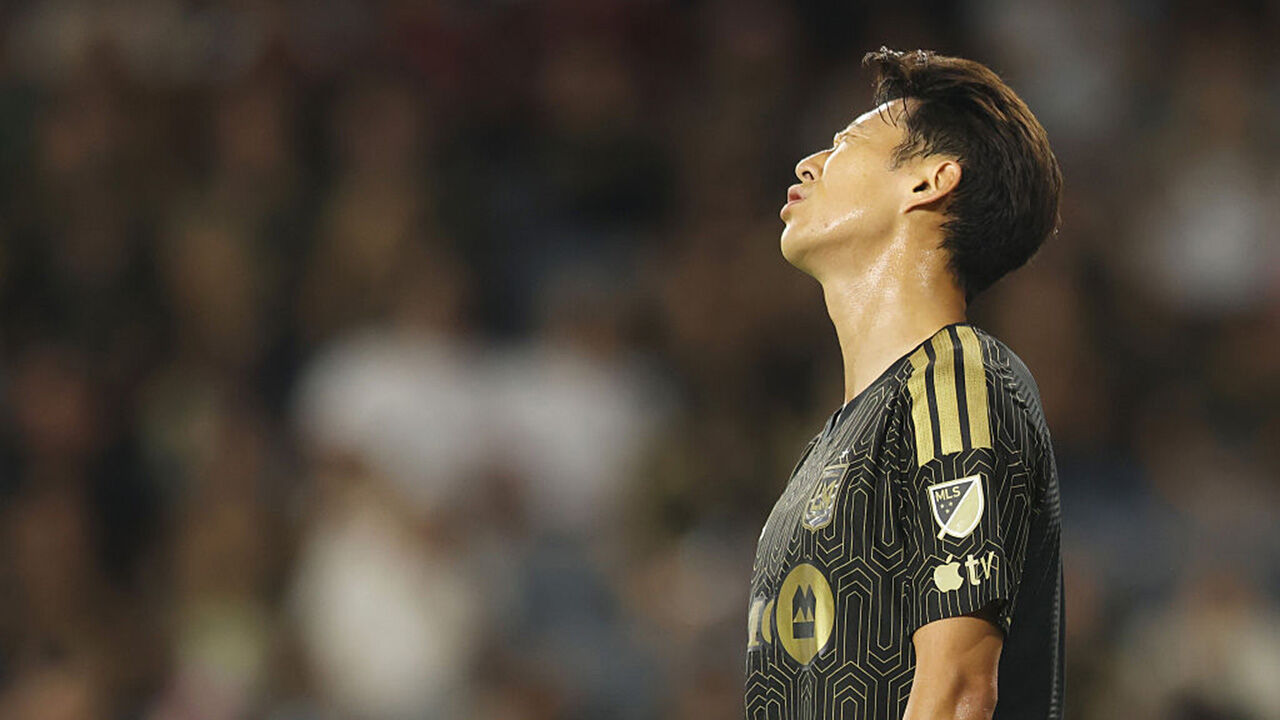
손흥민 선제골 발판·골대 불운…LAFC, 7경기 만에 승리
2 weeks ago
43

[르포] '더 똑똑해진 전동 칫솔' 다이슨, 카메라젯 첫 공개···AI 탑재로 또 한 번 혁신
3 weeks ago
42

OpenAI 에이전트들이 RubyGems에 공개되지 않은 공격을 수행함
2 weeks ago
38
 English (US) ·
© Clint IT 2026. All rights are reserved
