 1 hour ago
1
DuckDB 2.0 알파는 비동기 I/O, 재귀 CTE 엔진 재작성, VARIANT 필드 분리 저장으로 성능을 높임. 다만 개선 폭은 데이터 구조에 따라 다르며, 측정값은 M5 노트북 한 대와 가정용 인터넷 환경에서 얻은 결과임 S3 읽기는 별도 다운로드 스레드 풀이 데이터를 미리 가져와 네트워크와 CPU를 동시에 활용함. 기본 설정에서도 쿼리 수정 없이 대형 파일 읽기가 약 2~3배 빨라졌지만, 작은 파일 다수에는 효과가 미미함 재귀 CTE는 매 단계 전체 테이블을 다시 읽는 대신 한 번 구축한 조회 구조를 재사용함. 2만 커밋의 조상 탐색은 1.5.5의 실행별 1.8~16초에서 2.0 알파의 일관된 0.10초로 줄어듦 VARIANT는 여러 행에 일관되게 등장하는 필드를 내부 열로 분리함. 500만 이벤트 실험에서 JSON 문자열보다 저장 공간은 2.7배 작고, 분리된 필드의 필터/집계는 약 6배 빨랐지만 리스트 형 변환은 오히려 느렸음 데이터 모델링은 여전히 중요함. 자주 조회하는 필드는 실제 타입 지정 열로 만들고, 값의 타입을 일관되게 유지하며, 깊은 계층은 정수 ID를 사용하는 부모/자식 테이블로 관리하는 것이 권장됨 알파 성능 수치의 전제 DuckDB 2.0은 2026년 가을 출시 예정이며, 알파 버전이 공개된 상태임 모든 측정은 M5 노트북 한 대와 가정용 인터넷에서 진행됐으며, 인터넷 환경은 두 버전 모두에 비슷한 제약을 줌 S3 대상 리전은 us-east-1이며, 클라우드 컴퓨팅 환경에서는 더 빠를 수 있음 수치를 인용하기 전에 자신의 환경에서 직접 측정할 필요가 있음 비동기 I/O: S3 다운로드와 연산을 병렬로 수행 비동기 I/O는 다운로드와 CPU 연산을 분리해, 워커가 데이터를 기다리느라 쉬는 시간을 줄임 1.5.5에서는 워커 18개가 각각 다운로드, 대기, 디코딩을 순차 수행하므로 동시 다운로드도 최대 18개였음 2.0에서는 별도 스레드 풀이 수십 개 행 그룹을 미리 다운로드해 버퍼에 보관하고, 워커는 준비된 데이터를 디코딩함 첫 실험은 Stack Overflow 투표 데이터가 담긴 2.2GB Parquet 파일에서 투표 유형별 개수를 집계함 전체 2억 2,800만 행, 2,268개 행 그룹이며, 행 그룹당 약 12만 2,000행임 4개 열 중 하나만 읽어 실제 읽기량은 약 230MB였음 enable_external_file_cache = false로 설정해 매번 실제 S3에 접근하도록...
Related

Jeff - 집에서 학습한 Jev 호환 0.8B 의사결정 모델, 약 30ms
1 hour ago
0
World Labs, AMD에 합류
1 hour ago
1
AI 연구소를 조사할 때다
1 hour ago
1
인덱스 하나 더의 참을 수 없는 가벼움
1 hour ago
0
Diskless Kafka: 브로커가 데이터를 소유하지 않으면 무엇이 달라질까?
1 hour ago
1
대부분의 기술 혁명은 직원들의 일을 더 힘들게 만들었다
1 hour ago
1
진지한 AI 제품은 어떤 모습이어야 할까?
2 hours ago
1
Show HN: HN.watch - 모든 Hacker News 게시물을 영상으로
3 hours ago
1
Popular


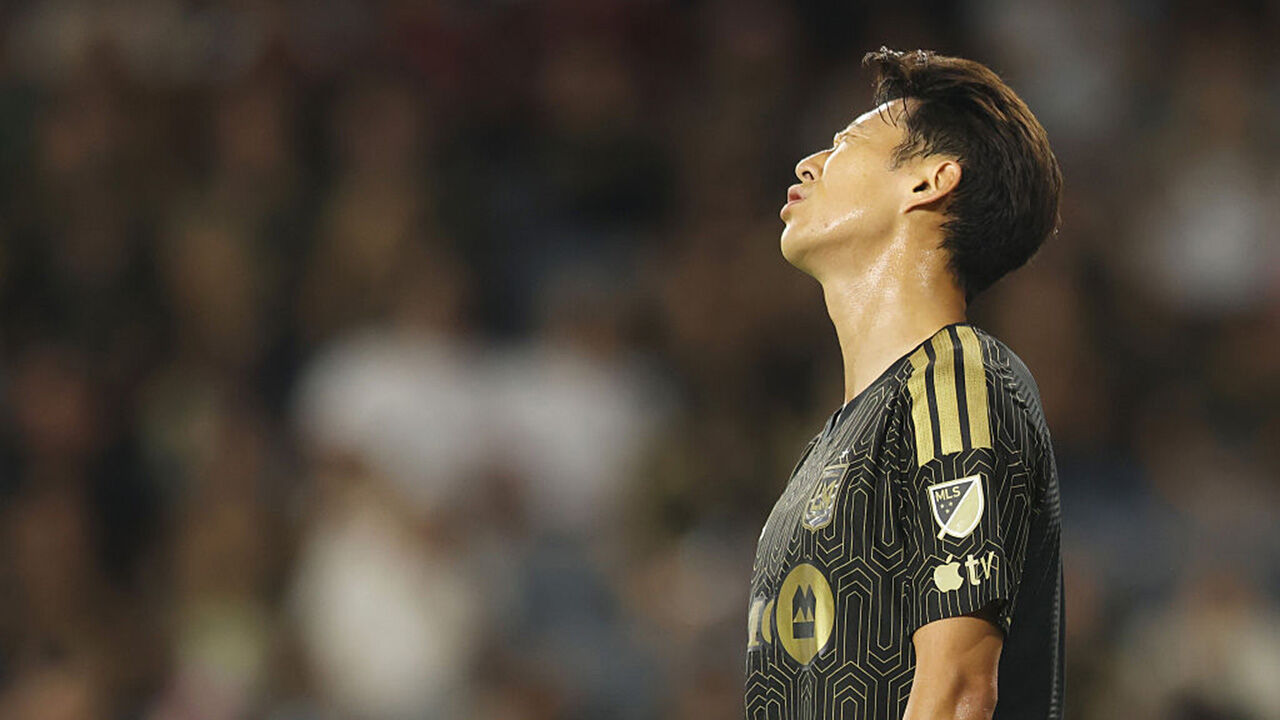
손흥민 선제골 발판·골대 불운…LAFC, 7경기 만에 승리
2 weeks ago
43

[르포] '더 똑똑해진 전동 칫솔' 다이슨, 카메라젯 첫 공개···AI 탑재로 또 한 번 혁신
3 weeks ago
42

OpenAI 에이전트들이 RubyGems에 공개되지 않은 공격을 수행함
2 weeks ago
38
 English (US) ·
© Clint IT 2026. All rights are reserved
