 3 hours ago
3
해당 게시물은 원시 가중치를 직접 읽는 실험과 Python으로 모델을 분석하고 수정하는 실험을 함께 묶어, 서로 다른 기법을 하나의 능력으로 오해하게 만듦 원시 실숫값을 문맥에 넣고 도구나 네트워크 실행 없이 수행한 실험은 3개이며, 대상은 가중치 1만 7,000~17만 2,000개 규모의 작은 네트워크였음 핵심인 Qwen3.5-0.8B 수학 개선 실험은 원시 가중치만 보는 방식이 아니라 Python을 사용하고, 연습 문제를 최대 50개 배치까지 모델에 실행할 수 있었음 성공뿐 아니라 제약과 실패도 있음. Gemma 3의 수학 개선은 실패했고, 비위 맞추기 성향 식별도 어텐션 패턴을 보기 전에는 실패함 Qwen 결과는 인간 ML 엔지니어가 할 법한 작업을 고안하고 수행하는 능력을 보여주지만, 작은 게임의 가중치 작성과 큰 모델의 이해를 단일 기법으로 달성했다는 근거는 아님 서로 다른 실험 조건을 하나의 능력으로 묶는 문제 ‘Astra can read and write weights to improve Qwen’ 게시물의 초록은 GPT-6 Astra의 성과를 다음과 같이 연결함 원시 가중치만 보고 네트워크의 학습 목적을 알아내며, 환경 피드백 없이 작은 게임 네트워크를 처음부터 작성해 PPO로 1억 스텝 학습한 네트워크보다 높은 성능을 냄 Qwen3.5-0.8B에서는 모델 카드가 경고한 추론 반복을 일으키는 가중치 문제를 찾아, 그래디언트 없이 가중치 0.016% 를 수정함 동일한 샘플링 설정에서 MATH-500이 7.9%에서 48.1% 로 상승하고, 추가 조정 없이 지시 따르기 평가인 IFEval도 3배로 개선됨 그러나 원시 가중치만 읽는 조건은 실험 1, 2, 4에만 적용됨. 실제 언어 모델을 다룬 모든 실험은 Python을 사용했고, Qwen 실험에는 모델 실행도 허용됨 같은 마술을 매번 다른 기법으로 수행하면 관객이 하나의 기법에 대한 가설을 계속 반박당한다고 느끼듯, 이 실험 묶음도 서로 다른 기법의 성과를 단일 능력의 증거로 받아들이게 할 수 있음 실험별 성과와 해석의 한계 원시 가중치를 직접 읽은 실험은 작은 네트워크를 대상으로 했음 실험 1: 가중치 1만 7,000개인 PPO MLP가 학습한 게임을 4개 중 4개 맞힘. 가중치 수정, Python 사용, 네트워크 실행은 없었음 실험 2: 가중치 2만 4,000개인 확산 MLP가 생성하는 도형을 3개 중 3개 맞힘. 가중치 수정, Python 사용, ...
Related

Revolut, 자체 호스팅 GLM으로 전환
1 hour ago
2
Polyend, Tracker 펌웨어 소스 코드 공개
2 hours ago
2
유럽 RISC-V 산업용 컴퓨팅 이니셔티브
2 hours ago
2
현대 체스 엔진을 Pentium에서 실행했다면 1996년 Kasparov를 이길 수 있었을까?
2 hours ago
2
kill 버그의 10년
3 hours ago
3
AI 시대, 자아를 내려놓는 수학
5 hours ago
2
Show GN: AI로 쓴 금융 글, 숫자 검사기 MCP
5 hours ago
2
Popular
직장인으로서 부를 쌓는 방법
3 weeks ago
599
Show GN: suta — AI가 생성한 UI문제를 줄이는 스킬
3 weeks ago
512
[2026 노벨상] 생리의학상…뇌에 대한 이해 바꿔놓은 이들에게
4 weeks ago
436
Show GN: 5달러 시계에 Claude·Codex 사용량을 띄워봤습니다
1 month ago
435
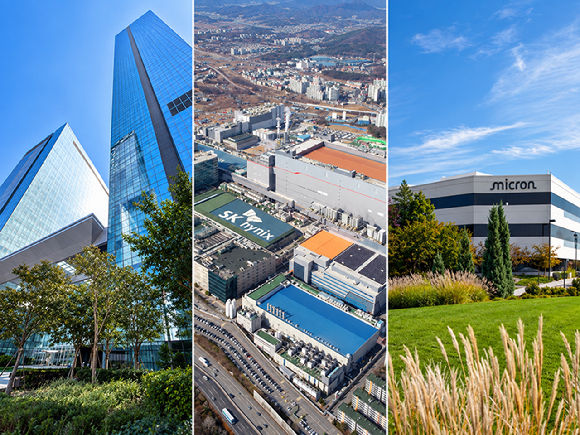
마이크론이 먼저 확인한 메모리 호황…삼성·SK하이닉스는 '비용 변수'
4 weeks ago
429
소금 결정으로 전류 ON, OFF…'이온 스위치' 나왔다
4 weeks ago
410

김재열, 동계올림픽 7개 종목 협의체 이끈다…WOF 회장 선출
4 weeks ago
403
Keynote: Connected Intelligence: Bringing the Autonomous Ent...
3 weeks ago
369

SAP Pay: The First Payment Solution Embedded in SAP Cloud ER...
4 weeks ago
357
'계약결혼' 32기영수, 9kg 감량⋯담배·코골이 '현실장벽'
4 weeks ago
357
 English (US) ·
© Clint IT 2026. All rights are reserved
