 5 hours ago
1
LLM에 선택지를 문자로 제시하고 토큰 로그 확률을 읽어, 분류 결과와 참일 확률, 순서형 점수를 반환하는 단일 Python 함수 score()를 구현함 긴 답변 대신 선택지 문자 하나를 생성하도록 요청해 출력 시간을 줄임. 입력 처리 비용은 남지만, 백엔드가 지원하면 공통 상태 접두사를 KV 캐시로 재사용할 수 있음 Jev 스타일 요청에 attachments 필드를 추가해 비전 모델에도 적용함. 웹캠 이미지를 보내 사람의 존재 여부, 실내외 구분, 장면 밝기 등을 자연어 질문으로 판별함 프레임당 질문 3개를 처리한 실험에서 RTX 3090의 Gemma 4 12B는 약 1 FPS, OpenAI의 gpt-6-luna는 약 0.2 FPS를 기록함. OpenAI 실험은 질문별 연결 비용을 줄이도록 최적화하지 않았음 전용 컴퓨터 비전 모델이 효율에서는 훨씬 유리하지만, 이 방식은 자연어 설명만 바꿔 판별 조건을 변경할 수 있는 유연성이 있음 토큰 확률로 선택지를 평가하는 방식 Jev와 자체 호스팅 가능한 OpenJev, SemIf에서 착안했으며, 토큰 확률을 읽는 기법은 OpenAI의 logprobs 쿡북에도 나와 있음 상태와 질문, 문자로 표시한 선택지를 프롬프트에 넣고 가장 적합한 선택지의 문자만 답하도록 요청함 예를 들어 “주문한 물건이 파손되어 환불을 원한다”는 상태에 담당 팀을 묻고, [A] billing, [B] shipping, [C] returns를 제시함 호환되는 Chat Completions 요청에 max_completion_tokens: 1, logprobs: true, top_logprobs: 20을 추가하면 출력 문자와 대체 토큰의 로그 확률을 받을 수 있음 질문마다 요청을 반복하므로 입력 처리 비용은 남아 있음. 백엔드가 지원하면 공통 상태 접두사를 KV 캐시로 재사용할 수 있음 단일 함수의 입력과 반환값 score(data, url, model) 함수는 공통 state와 이름별 questions를 받아 결과를 answers에 담아 반환함 state와 질문의 instructions가 문자열이 아니면 JSON 문자열로 변환함 질문마다 선택지는 2~20개여야 하며, A부터 T까지의 문자에 대응시킴 세 가지 질문 유형을 지원함 choice: 가장 확률이 높은 선택지와 각 선택지의 확률을 반환함 noul: true와 false를 기본 선택지로 두고 추가 기준을 병합하며, true의 확률을 반환함 sc...
Related

Show GN: 자조모임 BBS 무료 게시판/대화방
41 minutes ago
0
LLM 시대에도 프로그래밍을 계속 즐기는 법
51 minutes ago
0
Postgres 마이그레이션은 안전할까, 안전하지 않을까?
54 minutes ago
0
Johannes Doerfert를 추모하며
1 hour ago
1
급락하는 시험 성적은 서서히 진행되는 재앙이다
3 hours ago
0
PipePipe - SponsorBlock을 구현한 NewPipe 하드 포크
3 hours ago
1
화제가 된 Giants 영상 속 엄마입니다. 제 남편 이야기를 들려드릴게요
3 hours ago
0
Floci - 모든 클라우드 서비스를 로컬에서 에뮬레이션
4 hours ago
0
Popular

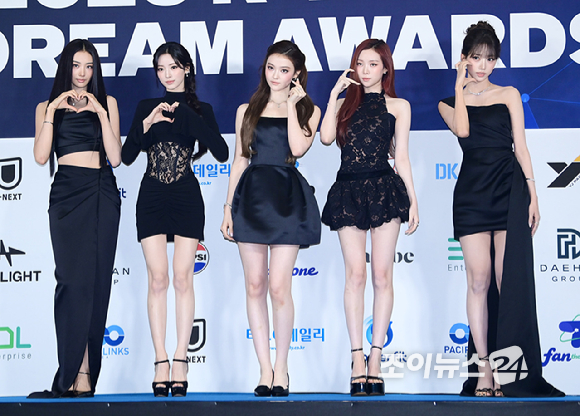
[포토] 미야오, 여신 비주얼
4 weeks ago
42


[르포] '더 똑똑해진 전동 칫솔' 다이슨, 카메라젯 첫 공개···AI 탑재로 또 한 번 혁신
3 weeks ago
38
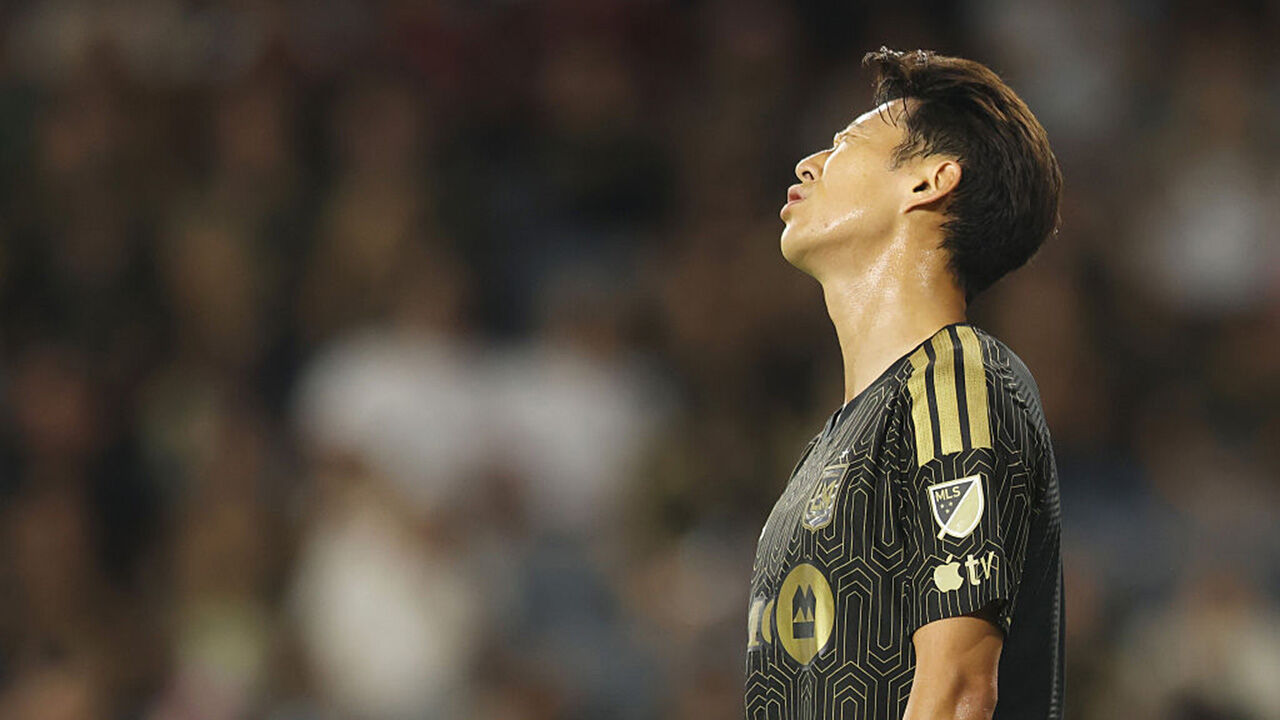
손흥민 선제골 발판·골대 불운…LAFC, 7경기 만에 승리
2 weeks ago
38

 English (US) ·
© Clint IT 2026. All rights are reserved
