 2 hours ago
3
StarSkirmish Bench v0.2는 LLM에 1시간 동안 C++로 StarCraft: Brood War의 Protoss 봇을 만들게 하고, 연습 경기에서 얻은 정보를 반영하는 장기 추론과 에이전트 코딩 능력을 평가함 GPT-6 Astra가 평균 승률 57%로 1위, GPT-6.1 Sol이 46%로 2위를 기록했으며, Gemini 4 Argon과 Claude Opus 5.5, Claude Fable 5.1은 37~39%로 사실상 동률을 이룸 강한 상대와의 연습량이 모델 점수를 가장 잘 예측했지만, Claude Fable 5.1은 대부분 약한 봇과만 연습하고도 37점을 기록한 예외임 인간이 작성한 최상위 봇과의 격차는 여전히 큼. GPT-6 Astra도 Stardust, PurpleWave, BananaBrain 상대 승률은 7% 에 그쳐 벤치마크가 포화됐다고 보기 어려움 기존 종합 평가와의 상관관계는 약해졌지만, Vals IOI와 WeirdML v3처럼 어려운 코딩 과제를 평가하는 벤치마크와는 높은 순위 상관관계를 유지함 평가 목적과 전체 성적 StarSkirmish는 LLM이 실제 경과 시간 1시간 안에 얼마나 강한 StarCraft 봇을 작성하는지 평가함 연습 경기의 교훈을 코드에 반영해야 하므로 장기 추론과 에이전트 코딩을 함께 시험함 v0.1의 평가 구성을 OpenAI, Anthropic, Google, Meta의 최신 모델과 각 개발사의 공식 CLI 하네스로 갱신함 모델별로 5회 실행하며, 각 실행에서 완성한 봇이 고정 상대 명단을 상대로 거둔 평균 승률을 0~100점으로 계산함 GPT-6 Astra: 57점 GPT-6.1 Sol: 46점 Gemini 4 Argon: 39점 Claude Opus 5.5: 39점 Claude Fable 5.1: 37점 Claude Sonnet 5.5: 26점 Muse Wonder Full: 21점 Claude Haiku 5.5: 21점 GPT-6 Luna: 13점 GPT-6.1 Sol의 비용 대비 성능이 두드러짐. 실행당 평균 API 비용이 GPT-6 Astra의 10분의 1을 조금 넘는 수준이면서 성적은 2위임 Muse Wonder Full의 비용은 Muse Wonder API 가격을 기준으로 산정함 인간이 작성한 최상위 봇과의 격차 Stardust, PurpleWave, BananaBrain은 모든 모델의 봇보다 여전히 훨씬 강함 GPT-6 Astra의 상대 ...
Related

사과문: Elevation Lab, AirTag 무음화 도구 판매 중단
43 minutes ago
3
Show HN: Flipflop - Iroh 기반 파일 공유용 지속형 터널
46 minutes ago
2
Anthropic, 6월에 투기등급 중 가장 높은 신용등급 받아
49 minutes ago
2
Big Fish: OpenBSD의 37년 된 커널 버그 악용하기
1 hour ago
3
Waymo, 토론토에 자율주행 차량 호출 서비스 진출 준비
1 hour ago
3
Claude, ECDSA 곡선의 기원을 밝혀내다
1 hour ago
3
Postgres 19 출시 지연, AI 리뷰가 사람이 고칠 수 있는 양보다 많은 버그를 발견
2 hours ago
4
미국 하원의원, 비디오게임 소유권 보호 법안 발의 계획 발표
2 hours ago
2
Popular

[아시안게임] 유도 김민종, 남자 100㎏이상급 동메달…2회 연속 메달
2 weeks ago
181

How DataXStream Accelerates Sales and Customer Engagement wi...
2 weeks ago
173
마이크론이 먼저 확인한 메모리 호황…삼성·SK하이닉스는 '비용 변수'
1 week ago
171
[2026 노벨상] 생리의학상…뇌에 대한 이해 바꿔놓은 이들에게
1 week ago
168

박진영, 12월 서울서 사흘간 연말 콘서트 '웨트'
1 week ago
167
Show GN: 5달러 시계에 Claude·Codex 사용량을 띄워봤습니다
1 week ago
166
방탄소년단, 자체예능 '달려라 방탄 2.0'으로 돌아온다
2 weeks ago
163

Accelerate your SAP modernization with Kiro
2 weeks ago
161
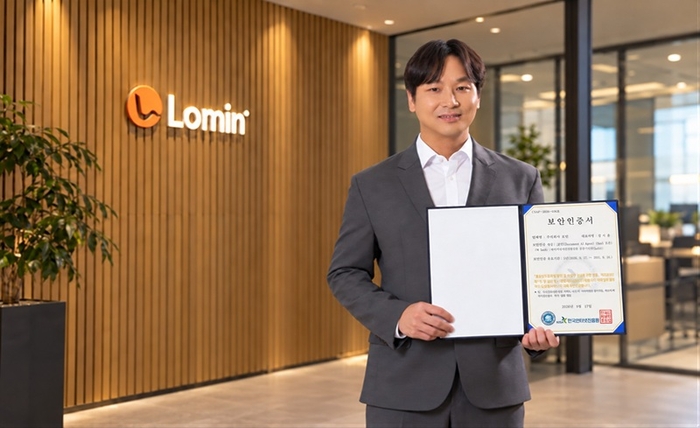
로민 '다큐먼트 AI 플랫폼', KISA 클라우드 보안인증 획득
2 weeks ago
155

김재열, 동계올림픽 7개 종목 협의체 이끈다…WOF 회장 선출
1 week ago
152
 English (US) ·
© Clint IT 2026. All rights are reserved
