 1 hour ago
3
Liquid AI가 전체 240억 개 중 토큰당 20억 개 파라미터만 활성화하는 추론 모델 LFM2.5-24B-A2B를 공개함. 기기 내에서 빠르게 작동하는 에이전트를 목표로 하며, 기본 모델과 후학습 모델 모두 오픈웨이트로 제공함 이전 모델과 달리 최종 답변 전에 명시적인 사고 과정을 생성하는 추론 전용 모델임. 컨텍스트 창을 131,072토큰으로 확장하고 사전학습 규모와 강화학습을 늘림 Liquid AI 평가에서 도구 사용 및 에이전트 벤치마크 8개 중 5개에서 비교 모델과 동등하거나 우수한 성능을 기록함. 지시 이행에서는 강점을 보였지만, 지식 중심 작업과 코딩에서는 더 큰 모델들이 우세함 자체 측정에서 Apple M5 Max의 생성 속도는 초당 184토큰, 단일 NVIDIA B300의 처리량은 최대 초당 21,000 출력 토큰임. 온디바이스에서는 비교 대상 MoE보다 최대 1.7배 빠름 llama.cpp, MLX, vLLM, SGLang, ONNX를 출시일부터 지원함. M5 Max MacBook Pro에서 Hermes Agent를 구동한 데모는 클라우드 API 호출 없이 계획, 도구 호출, 작업 수행을 기기 내에서 처리함 모델 구성과 이전 버전 대비 변화 LFM2.5-24B-A2B 는 LFM2.5 제품군의 가장 큰 모델이자 마지막 모델임 제품군은 LFM2.5-230M의 2억 3,000만 개부터 240억 개 파라미터까지 약 100배 범위를 포괄함 기본 모델 LFM2.5-24B-A2B-Base와 후학습 모델 LFM2.5-24B-A2B를 오픈웨이트로 공개하며, Playground에서도 이용할 수 있음 이전 LFM2-24B-A2B의 하이브리드 아키텍처를 유지함 40개 레이어, MoE 블록당 전문가 64개와 top-4 라우팅, 게이트형 짧은 합성곱과 GQA 조합을 사용함 컨텍스트 창은 32,768토큰에서 131,072토큰으로 확대함 기존 토크나이저 확장으로 어휘 크기를 65K에서 128K토큰으로 늘려 비라틴 문자 토큰화를 개선함 추론 전용으로 전환해 최종 답변 전에 명시적 사고 과정을 생성함. 높은 디코딩 속도를 활용해 답변 품질을 높이기 위한 선택임 학습 파이프라인과 보상 해킹 대응 사전학습 데이터 규모를 17조 토큰에서 33조 토큰으로 늘림 중간학습은 두 단계로 진행함 첫 단계는 32K 컨텍스트에서 고품질 데이터 2조 토큰을 학습하며, 추론, 수학, 코드, 지시 이행, 다국어 텍스트에 비중을 둠 두 번째 단계...
Related

Show GN: 맥 os용 의미론적 검색 인덱스, Weft
2 hours ago
4
Apple: Chrome에서 Safari로 전환하세요
3 hours ago
3
Starlink 속도 제한, 우크라이나 드론 운용에 타격
4 hours ago
3
미국은 희토류 산업을 잃은 것이 아니라 팔았다
4 hours ago
3
코드를 모르는 기획자의 Product Engineer 도전 : 준비와 소통으로 서버부터 앱까지
4 hours ago
3
Tiny Little Office - 링크 자체가 문서인 소형 오피스 제품군
5 hours ago
3
State of AI 2026 - AI가 AI를 개발하는 시대, 추론 산업과 물리 AI의 부상
6 hours ago
3
Popular

[아시안게임] 유도 김민종, 남자 100㎏이상급 동메달…2회 연속 메달
1 week ago
162


박진영, 12월 서울서 사흘간 연말 콘서트 '웨트'
1 week ago
148
마이크론이 먼저 확인한 메모리 호황…삼성·SK하이닉스는 '비용 변수'
1 week ago
148
Show GN: 5달러 시계에 Claude·Codex 사용량을 띄워봤습니다
1 week ago
146
[2026 노벨상] 생리의학상…뇌에 대한 이해 바꿔놓은 이들에게
1 week ago
144
방탄소년단, 자체예능 '달려라 방탄 2.0'으로 돌아온다
2 weeks ago
143

Accelerate your SAP modernization with Kiro
2 weeks ago
139
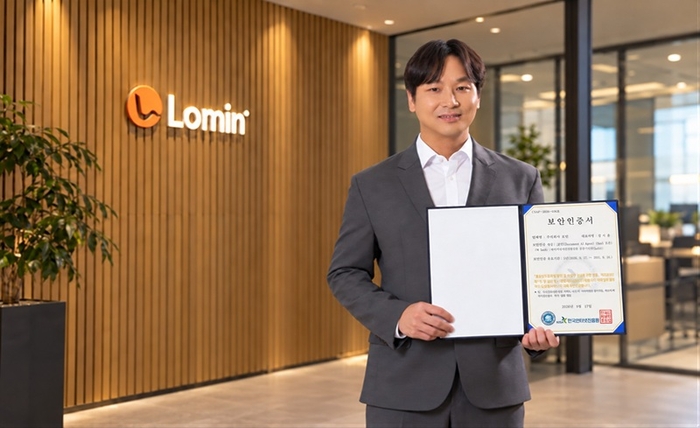
로민 '다큐먼트 AI 플랫폼', KISA 클라우드 보안인증 획득
1 week ago
131

김재열, 동계올림픽 7개 종목 협의체 이끈다…WOF 회장 선출
1 week ago
130
 English (US) ·
© Clint IT 2026. All rights are reserved
