 2 hours ago
4
Cerebras는 대규모 모델의 가중치를 여러 WSE-3T 웨이퍼의 온칩 메모리에 나눠 배치하고 파이프라인으로 실행해, 수조 개 파라미터 모델을 초당 1,000~2,000개 이상의 토큰 속도로 구동함 약 3조 파라미터의 Kimi K3는 4비트 가중치 양자화와 요청당 평균 256k 토큰 등의 가정에서 총 59개 웨이퍼에 배치할 수 있음 레이어 전체를 온칩 SRAM에 담을 수 있어 대부분의 경우 가중치는 이동하지 않고 활성화 값만 웨이퍼 사이를 이동하며, Ethernet 기반 RDMA의 홉당 지연은 약 2마이크로초임 각 파이프라인 단계가 서로 다른 요청을 동시에 처리하며, 요청을 묶는 마이크로배치가 작으면 개별 요청 속도에, 크면 전체 처리량에 유리함 동시 요청 수는 KV 캐시용 온칩 메모리에 제한되지만, 시스템 효율은 동시성이나 배치 크기보다 동일한 출력 생성 속도에서의 전력당 총 토큰 처리량으로 평가해야 함 Kimi K3로 살펴보는 배포 조건 단일 WSE-3T 웨이퍼에는 온칩 메모리가 44GB 있지만, 조 단위 파라미터 모델은 가중치만으로도 테라바이트 단위의 메모리가 필요함 예시 모델인 Kimi K3는 약 3조 파라미터의 오픈소스 모델로, 선형 어텐션 레이어 69개와 전체 어텐션을 수행하는 밀집 레이어 24개로 구성됨 Terminal-Bench 2.1에서 88.3%를 기록했으며, 비교 대상인 GPT-5.6 Sol은 88.8%임 BrowseComp에서는 91.2%로 GPT-5.6 Sol의 90.4%를 웃돌아, 일부 벤치마크에서 선도적인 독점 모델보다 높은 코딩/에이전트 역량을 보임 모델 관련 추가 자료는 Kimi K3 소개에서 확인할 수 있음 배치 계산은 요청당 평균 256k 토큰, Hugging Face 구현과 같은 4비트 가중치 양자화, 8비트 KV 캐시를 가정함 레이어 크기와 웨이퍼 수 계산 3조 파라미터를 각각 4비트로 저장한 가중치 용량을 93개 레이어로 나누면 레이어당 약 16GB가 됨 밀집 레이어는 활성 요청의 모든 토큰에 대한 키와 값을 저장해야 하므로, 웨이퍼당 레이어 1개만 배치하고 남은 SRAM을 KV 캐시에 할당함 선형 어텐션 레이어는 토큰별 키와 값 대신 문맥 길이에 관계없이 요청당 작은 고정 크기 상태를 유지함 KV 캐시 공간을 별도로 확보할 필요가 없어 웨이퍼당 레이어 2개를 배치할 수 있으며, 가중치가 차지하는 용량은 약 32GB임 선형 레이어 69개와 밀집 레이어 24개를 배치하려면...
Related

SpeedCrunch 1.1 - 최대 50자리 정밀도의 무료 오픈소스 공학용 계산기
2 hours ago
3
Qwen3.8-27B 모델 5개, GVS5H 하네스로 Fable 5에 필적하는 성능 달성
4 hours ago
3
Meta 직원들, 브라질 선거 중 Lula 계정 제한 인정했다는 보도
4 hours ago
3
Ask GN: 대화가 길어지면 AI가 점점 멍청해지는거 같은데 뭔 문제에요?
4 hours ago
3
C++26 투표 종료, 안타깝게도 부결됨
4 hours ago
3
Cohere, Rerank 5 공개 - 검색 결과 재정렬부터 문서 속 핵심 구절 추출까지
5 hours ago
3
AI는 무엇이 문제인가?
5 hours ago
3
대한민국 헌법을 보고, 느끼고, 작성해보기.
6 hours ago
3
Popular
직장인으로서 부를 쌓는 방법
1 week ago
355

[아시안게임] 유도 김민종, 남자 100㎏이상급 동메달…2회 연속 메달
3 weeks ago
309
[2026 노벨상] 생리의학상…뇌에 대한 이해 바꿔놓은 이들에게
2 weeks ago
299
Show GN: 5달러 시계에 Claude·Codex 사용량을 띄워봤습니다
3 weeks ago
298
마이크론이 먼저 확인한 메모리 호황…삼성·SK하이닉스는 '비용 변수'
3 weeks ago
297

How DataXStream Accelerates Sales and Customer Engagement wi...
3 weeks ago
295
방탄소년단, 자체예능 '달려라 방탄 2.0'으로 돌아온다
3 weeks ago
293

박진영, 12월 서울서 사흘간 연말 콘서트 '웨트'
3 weeks ago
290
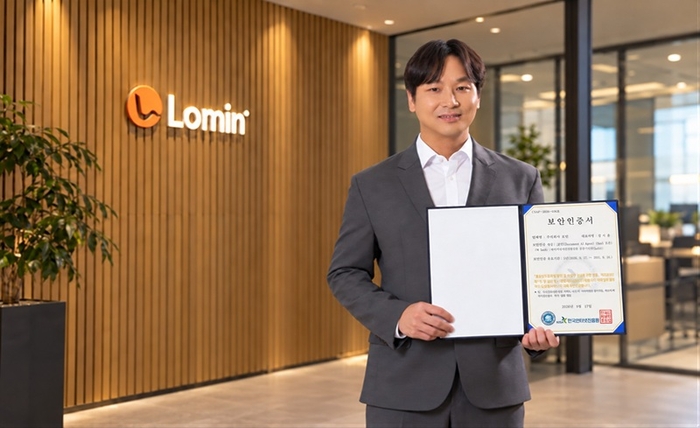
로민 '다큐먼트 AI 플랫폼', KISA 클라우드 보안인증 획득
3 weeks ago
284

Accelerate your SAP modernization with Kiro
3 weeks ago
280
 English (US) ·
© Clint IT 2026. All rights are reserved
