 1 week ago
13
재귀적 자기개선(RSI) 의 관건은 AI가 실험 코드를 잘 작성하는 데서 나아가, 연구 목표를 정하고 결과를 해석하며 다음 목표를 선택하는 순환을 인간 없이 지속할 수 있느냐임 현재의 Transformer와 강화학습(RL) 만으로도 연구가 크게 빨라질 수 있지만, 기존 목표의 최적화가 새로운 연구 패러다임의 발명으로 이어질지는 의견이 갈림 시뮬레이션에서 현실로의 전이와 지속학습이 주요 병목 후보임. 장기 업무의 인간 상호작용을 모사하기 어렵고, 소량의 새 경험으로 모델을 반복 갱신하면 망각과 능력 저하가 발생할 수 있음 RL 환경 확대와 증류는 능력 향상을 뒷받침하지만, 현실적인 프롬프트 분포와 현재 능력의 경계를 넘는 학습 신호가 필요함. 벤치마크만 따라잡아서는 실제 업무 역량까지 복제하기 어려움 AI 연구 생산성 10배 향상의 예상 시점은 약 2년부터 5~10년까지 갈림. 컴퓨터 기반 모든 분야에서 최고 인간 전문가를 능가하는 AI도 3~4년과 5~10년 전망이 공존하며, 장기 학습과 분야별 차이라는 조건이 붙음 2036년에도 초지능이 세계를 바꾸지 못한다면 논의의 출발점은 전쟁이나 AI 금지 같은 외부 충격을 제외하고, 2036년에도 수십억 개의 초지능이 세계를 급격히 바꾸지 못할 기술적 이유가 무엇인지임 Beren Millidge는 벤치마크와 훈련 환경에서는 뛰어나지만 현실 전이, 메타학습의 일반화, 지속학습이 막힐 수 있다고 봄 다만 이미 RL에서도 일반화가 관찰되므로 이 시나리오의 가능성은 낮게 평가함 John Schulman은 판단력과 자기 검증의 약점이 연구와 엔지니어링의 병목으로 남을 수 있다고 봄 새 모델이 처음에는 AGI처럼 느껴지다가 한 달쯤 쓰면 부족함이 드러나는 주기가 예상보다 오래 반복될 수 있음 사람보다 훨씬 많은 코드를 작성한다고 생산성이 100배가 되는 것은 아님 Charlie O’Neill은 현재의 Transformer와 RL 조합이 칩 위에서 구현 가능한 최적의 학습기와 얼마나 떨어져 있는지가 중요하다고 봄 인간보다 AI 연구를 0.1%만 잘하는 에이전트라도 수십만~수백만 개를 병렬 실행하고 더 빠르게 작동시키면 다른 병목을 압도할 수 있다는 급속 도약 논리가 있음 반대로 현재 패러다임의 수익이 체감하고, 그 방식으로 훈련된 모델이 다음 혁신을 찾지 못할 수도 있음 무어의 법칙(Moore’s Law) 의 장기 추세도 여러 불연속적 혁신으로 유지됐듯, 사전학습 이후 RL이 새 ...
Related
그림 판당고 퍼즐 문서(1996년) [pdf]
13 minutes ago
0
소프트웨어 샌드박싱의 기초(2025)
35 minutes ago
0
MCP는 처음부터 잘못된 아이디어였을까?
1 hour ago
0
활발히 유지보수되고 업데이트되는 Motif 포크가 실제로 존재함
1 hour ago
0
Jev을 (형편없는) 챗봇으로 만들어 봄
2 hours ago
0
Show GN: Umtri.io - 프로젝트를 시각화하는 형상 관리 도구
2 hours ago
0
가장 별난 글자 W의 알아둘 만한 역사
3 hours ago
0
Popular

[팟캐스트] OAuth, 제대로 이해하고 쓰고 있나요?
4 weeks ago
97
고철
4 weeks ago
95

연상호, 토론토영화제서 고레에다 감독과 대담
4 weeks ago
84
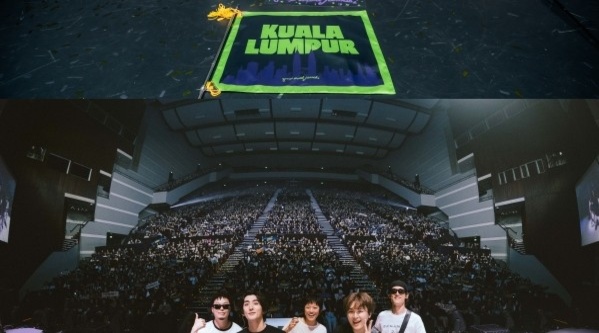
잔나비, 첫 아시아 투어 곳곳서 떼창 물결…"기적같은 일"
4 weeks ago
80
취준생 목소리에 귀기울인 '라이너 라이트'..."자소서 기능 이용자 수 13배 늘...
4 weeks ago
80

‘붉은사막’, 게임스컴 어워드 에픽·최고의 PC 게임 후보작 올라
3 weeks ago
78
김재윤 통산 220세이브…삼성, 2연패 탈출
4 weeks ago
74
컴투스, 신작 '제우스: 오만의 신' 사전 다운로드 당일 애플 앱스토어 인기 1위
3 weeks ago
72

남궁훈 아이즈 대표, 카카오게임즈 지분 1% 매입…"게임산업 다시 성장할 것"
4 weeks ago
69

 English (US) ·
© Clint IT 2026. All rights are reserved
