 35 minutes ago
1
llama-modchip은 모델 압축과 CPU 커널 최적화를 결합해 DeepSeek-V4-Flash 284B를 64GB RAM에서 실행함. 프로젝트 측 측정에서 256K 컨텍스트의 메모리 사용량은 57.61~58.9GiB이며, NVMe 스왑을 사용하지 않음 SwiGLU-H2 압축과 Fractal-64 변환으로 모델 파일을 76.87GiB에서 56.56GiB로 줄이고, 레지스터와 L1/L2/L3 캐시에 걸친 타일링으로 연산을 최적화함 Ryzen 9 9955HX에서 DeepSeek 284B의 프리필은 최대 44.36토큰/초, 기본 Top-6 디코딩은 9.06~9.95토큰/초를 기록함. Stockfish-PVS를 적용하면 11.5~14.7토큰/초로 높아짐 Nemotron-3.5-30B-A3B도 지원하며, 14.35GiB 양자화 모델은 같은 CPU에서 기본 디코딩 25.02토큰/초를 기록함. 추측 디코딩 측정치는 평균 48.39토큰/초, 최대 60.40토큰/초임 Claude Code 로컬 연결과 KV 상태 복원을 지원하지만, 전용 모델은 수정되지 않은 llama.cpp, Ollama, LM Studio에서 열 수 없음. 프로젝트 실행기나 전용 바이너리가 필요함 64GB 메모리에 맞춘 DeepSeek 284B llama-modchip v2.4.0은 CPU 중심의 로컬 MoE 추론 프로젝트로, DeepSeek-V4-Flash와 Nemotron 계열에 모델별 압축 및 실행 최적화를 적용함 DeepSeek-V4-Flash-0731은 전체 284.33B, 활성 13.17B 파라미터 모델이며, 43개 MLA 계층과 MoE 구조를 갖춤 기존 IQ2_XXS 파일은 76.87GiB로, 프로젝트의 64GB Linux 환경에서 메모리 부족이 발생함 변환 파일은 56.56GiB이며, 256K 컨텍스트에서 실제 상주 메모리인 VmRSS는 57.61~58.9GiB로 측정됨 모델과 컨텍스트를 RAM에 유지하며 NVMe 스왑을 사용하지 않음 압축과 CPU 연산 최적화 SwiGLU-H2는 해석적 2차 헤시안 압축을 MoE에 적용하고, Fractal-64는 MLA 텐서를 Q2_0, 3.75bpw 형식으로 변환함 4단계 타일링은 AVX-512BW ZMM 레지스터, L1D, L2, L3를 함께 활용함 여러 열을 묶는 프리필 타일링으로 DeepSeek 처리량이 25.0에서 44.36토큰/초로 약 77% 증가함 레지스터에 데이터를 유지하는 AVX-512 M...
Related

Ozempic 계열 약물, 심부전과 중독 넘어 노화까지 임상시험 중
1 hour ago
0
Person of Interest - 15년이 지난 드라마가 불러온 인터넷의 추억과 현실감
2 hours ago
0
GitHub, 또 장애인가?
3 hours ago
1
Meridian - Servo와 GPUI로 만든 실험적 웹 브라우저
4 hours ago
1
Google, 와이오밍주 남동부의 Crusoe 데이터센터 부지 인수
4 hours ago
1
Show GN: 라플라스의 가위 - LLM을 재학습하지 않고, 출력 가중치만 안전하게 수정.
5 hours ago
2
`free-router 실사용 후기 — 무료 AI 모델을 코딩 에이전트에 붙여 며칠 써보며 겪은 것`
5 hours ago
2
Popular
직장인으로서 부를 쌓는 방법
3 weeks ago
668
Show GN: suta — AI가 생성한 UI문제를 줄이는 스킬
4 weeks ago
581

'3연패 도전' 김효주, LET 아람코 코리아 2R 9위…박성현은 2위
4 weeks ago
355
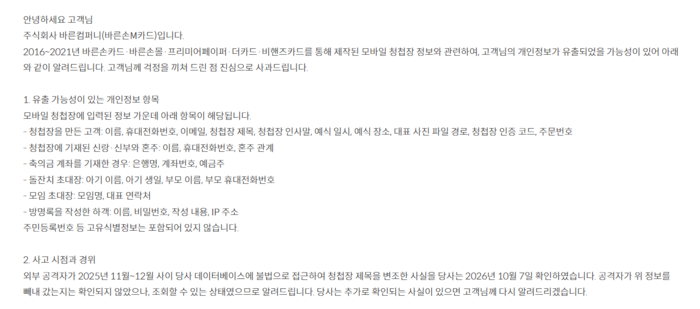
바른손M카드 해킹 뒤늦게 확인…축의금 계좌·아기 정보까지 유출 가능성
4 weeks ago
346
Claude Startups 프로그램, 모든 신청서 재검토 예정
4 weeks ago
345
[프로농구 중간순위] 9일
4 weeks ago
342

'클리말라 결승골' 서울, 제주 2-1 꺾고 자력 우승까지 '승점 7'(종합)
4 weeks ago
337

토트넘 감독, '박치기 퇴장' 벤탄쿠르에 "입맞추며 고맙다 말해"
4 weeks ago
336

프로농구 '우승후보' DB, 디펜딩챔프 KCC 제압…엘런슨 24점
4 weeks ago
333

울산 마라톤대회서 14명 열탈진 증세로 병원 이송
4 weeks ago
332
 English (US) ·
© Clint IT 2026. All rights are reserved
